Articles · Smallem : servir un modèle
Générer à plusieurs
Deuxième article de la série Smallem : servir un modèle. Précédent : Où part le temps d'un token.
L'article précédent a fini à 969 tokens par seconde, pour une borne de 7 400. Chaque token lit les 118 Mo du modèle pour une seule multiplication par poids, et la carte passe son temps à attendre sa mémoire, ou l'hôte.
Il y a une façon simple de mieux s'en servir : générer plusieurs séquences à la fois. Avec
B séquences, chaque poids lu sert B fois, pour la même lecture. Tant que la carte
attend sa mémoire, ces multiplications supplémentaires sont presque gratuites.
C'est aussi ce que demandera le post-entraînement : pour apprendre par essais, un modèle doit produire des dizaines de réponses à chaque consigne.
Des séquences de longueurs différentes
Le problème est connu. Les séquences d'un lot n'ont pas la même longueur : leurs amorces
diffèrent, et chacune s'arrête quand elle veut. Un tenseur [B, T, C] demande pourtant
que toutes aient T positions.
Les deux réponses habituelles complètent les séquences courtes par des tokens inutiles. Le remplissage à gauche les met au début, pour que toutes les séquences finissent au même endroit et que le token à prédire soit au même rang ; un masque empêche l'attention de les regarder. Le masque par séquence les met à la fin, et chaque séquence a sa propre position courante. Dans les deux cas, des calculs sont faits pour rien, et la gestion des positions de RoPE devient délicate.
Le cache de l'article précédent permet une troisième voie, celle des serveurs comme vLLM :
pas de remplissage du tout. Les nouveaux tokens de toutes les séquences sont mis bout à
bout et forment une seule suite [1, R, C]. Tout ce qui ne mélange pas les positions,
c'est-à-dire tout le modèle sauf l'attention, les traite comme une séquence ordinaire. Et
l'attention sait, par le cache, à quelle séquence appartient chaque token et quelles
lignes elle doit lire :
Une entrée par séquence, avec ses nouveaux tokens : toute l'amorce quand on la lit, un seul token ensuite. Les deux peuvent se mêler dans une même passe, une séquence qui lit son amorce pendant que les autres génèrent. Chaque token a sa position, et RoPE reçoit une table d'angles par token, plutôt qu'une plage de positions commune à tout le lot.
Au-dessus, un Batch mène les générations :
let mut batch = new;
let a = batch.add;
let b = batch.add;
while batch.running > 0
Chaque séquence a son arrêt : un token de fin, ou une longueur maximale. Une séquence terminée rend ses pages au cache, qui peuvent servir à une séquence ajoutée ensuite.
Le test qui compte : chaque séquence d'un lot donne exactement les tokens qu'elle donne
seule. Sur CPU, en f64, avec des amorces de longueurs différentes, pour l'attention
classique, l'attention latente et des positions apprises, et quand le cache de l'une glisse
au-delà du contexte et pas celui des autres.
La courbe, une première fois
Un programme mesure le débit : B amorces de 16 tokens prises dans le texte de
validation, puis 127 pas de génération gloutonne : à chaque pas, le token le plus
probable, sans tirage, comme avec --temperature 0.
| Lot | Tokens par seconde | Par séquence |
|---|---|---|
| 1 | 970 | 970 |
| 8 | 6 412 | 802 |
| 16 | 9 488 | 593 |
| 32 | 6 569 | 205 |
| 64 | 11 399 | 178 |
| 256 | 26 254 | 103 |
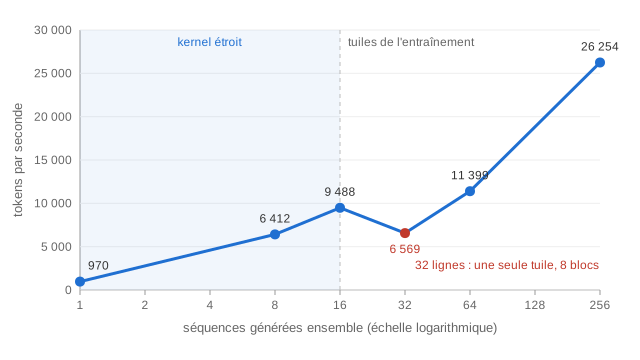
Jusqu'à 16 séquences, tout va bien. À 32, le débit s'effondre.
C'est le seuil du kernel de l'article précédent. Les produits d'au plus 16 lignes passent par le kernel des matrices étroites ; au-delà, par les tuiles de l'entraînement. Et celles-ci ont le défaut qui avait motivé le premier : 32 lignes tiennent dans une seule tuile de lignes, et la grille n'a de nouveau que 8 blocs pour une sortie de 512 colonnes.
Le remède est le même : découper la dimension commune en tranches, chacune confiée à
d'autres blocs, et additionner les sommes partielles ensuite. Les deux kernels en tuiles,
f32 et bf16, reçoivent une tranche à parcourir, [begin, end), au lieu de toute la
dimension commune :
let column_tiles = cols.div_ceil;
let = ;
let begin = split * depth;
let end = if begin + depth < inner else ;
Le découpage ne s'active que pour les produits d'au plus 256 lignes dont la grille serait trop petite. Les produits de l'entraînement, bien plus grands, gardent exactement leurs kernels, et leurs nombres.
Restait à placer la frontière entre les deux kernels. Durée d'un produit
[lignes, 512] · [512, 512], en microsecondes :
| Lignes | Étroit | Tuiles f32 | Tuiles bf16 |
|---|---|---|---|
| 1 | 7,2 | 15,6 | 24,0 |
| 8 | 9,4 | 15,8 | 23,9 |
| 16 | 13,1 | 15,8 | 25,5 |
| 24 | 16,7 | 16,0 | 28,4 |
| 64 | 34,6 | 17,8 | 31,4 |
| 256 | 138,2 | 25,7 | 34,2 |
Le kernel étroit relit chaque poids pour chaque paquet de 8 lignes : il gagne jusqu'à 16
lignes, et perd vite ensuite. La frontière reste à 16. Et les Tensor Cores ne gagnent
nulle part : à ces tailles, convertir les opérandes en bf16 coûte plus que les
multiplications qu'ils accélèrent. Les mesures de cet article sont faites en f32.
Trois lenteurs de l'hôte
La courbe remontait, mais deux choses restaient étranges.
D'abord, la lecture des amorces : 111 ms pour 32 amorces de 16 tokens. Le profil de la
carte montrait 8 ms de calcul. Le reste était un envoi : les tables du cache sont créées à
la première écriture, par zeros, et zeros fabriquait ses zéros sur l'hôte avant de les
envoyer. Pour 32 séquences, 16 tables de 34 Mo. Le backend GPU sait maintenant remplir un
tenseur lui-même, par un kernel d'une ligne. Lire les 32 amorces prend 9 ms.
Ensuite, à 256 séquences, la carte ne calculait que 4,4 ms sur 7,8 par pas. L'hôte
tirait les tokens : même en mode glouton, il convertissait chaque ligne de 8 192 logits en
f64 et construisait une distribution complète avant d'y chercher le maximum. Un
argmax direct sur les nombres de la carte suffit.
Et il calculait les angles de RoPE : 2 048 lignes, une par token et par tête, chacune avec 32 puissances, 32 sinus et 32 cosinus. Les fréquences ne dépendent que de la paire, et les têtes d'un même token ont les mêmes angles : 32 puissances en tout, puis une ligne de sinus et de cosinus par token, recopiée pour chaque tête.
La courbe
| Lot | ms par pas | Tokens par seconde | Par séquence |
|---|---|---|---|
| 1 | 1,02 | 982 | 982 |
| 2 | 1,00 | 2 001 | 1 000 |
| 4 | 1,06 | 3 790 | 948 |
| 8 | 1,19 | 6 731 | 841 |
| 16 | 1,57 | 10 188 | 637 |
| 32 | 2,14 | 14 979 | 468 |
| 64 | 2,53 | 25 306 | 395 |
| 128 | 3,59 | 35 679 | 279 |
| 256 | 5,82 | 44 005 | 172 |
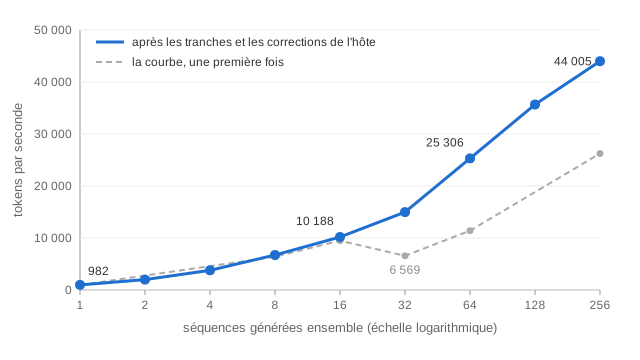
À 64 séquences, le débit total est 26 fois celui d'une séquence seule : la validation du plan en demandait vingt. À 256, 45 fois.
Et chaque séquence du lot reste celle qu'elle serait seule. Sur la carte, avec le vrai modèle, les 256 séquences du plus grand lot écrivent exactement les 128 tokens qu'elles écrivent seules, bien que leurs produits passent par d'autres kernels.
Où la courbe s'aplatit
Jusqu'à 8 séquences, un pas ne coûte presque rien de plus : 1,02 ms pour une, 1,19 pour huit. C'est ce que disait l'article précédent : une passe est faite de 245 kernels courts, dont le coût fixe domine, et huit lignes au lieu d'une n'y changent presque rien.
Au-delà, chaque doublement du lot coûte de plus en plus. La borne du « roofline » le
prévoit : une passe fait 0,5 × B opérations par octet de poids lu, et la carte passe du
côté du calcul vers B = 76, où l'on atteint ses 38 opérations par octet. À 256
séquences, un pas fait 15 milliards d'opérations, soit 0,43 ms aux 35,6 téraopérations
par seconde de la carte. Il en prend 5,8.
Le profil d'un pas à 256 séquences dit où :
- les produits matriciels prennent 2,5 ms : nos tuiles
f32atteignent environ 6 téraopérations par seconde sur ces formes, un sixième du maximum ; - l'attention prend 0,9 ms. C'est le cache qu'elle lit : 256 séquences de 80 positions en moyenne, à 32 Ko par position, soit 650 Mo par pas. Six fois le poids du modèle.
Ce second point est le plus important pour la suite. Avec une séquence, ce qu'on lit à chaque token, ce sont les poids. Avec beaucoup, ce sont les caches. Chaque séquence occupe 16,5 Mo de tables. A 256 séquences, le cache prend 4,2 Go sur la carte, et il grandit avec la longueur des réponses. C'est là que l'attention latente et les clés partagées de la première série, jugées inutiles à l'entraînement, retrouveront une raison d'être : au dernier article.
Ce qu'il faut retenir
- Générer à plusieurs, c'est amortir la lecture des poids : 26 fois le débit à 64 séquences, 45 fois à 256, chaque séquence donnant exactement ses tokens d'avant.
- Pas de remplissage : des tokens mis bout à bout, et une attention qui sait à quelle séquence appartient chacun.
- Chaque taille de lot a son kernel. Une grille trop petite pour la carte se rattrape en découpant la dimension commune.
- Une fois la carte rapide, l'hôte se voit : des zéros envoyés, une distribution complète
pour un
argmax, des sinus recalculés pour chaque tête. - À grand lot, ce qu'on lit à chaque pas n'est plus le modèle, mais les caches.
Article suivant : Huit bits, puis quatre.