Articles · Smallem : servir un modèle
Où part le temps d'un token
Premier article de la série Smallem : servir un modèle, qui prolonge Smallem : un LLM en Rust et CUDA, à partir de zéro.
La première série a passé presque tout son temps à entraîner. Son meilleur modèle, celui de l'article 16, a 29,4 millions de paramètres, et il écrit ainsi :
$ generate --model muon-short-long.safetensors --tokens 500 --temperature 0
225 tokens par seconde
225 tokens par seconde, sur une RTX 3090, pour un modèle aussi petit. C'est peu, mais à quel point ? Pour le savoir, il faut une borne : ce que la carte pourrait faire au mieux.
Une borne : la bande passante
Pour produire un token, le modèle fait une passe entière. Chacun de ses poids est lu une fois, et sert à une seule multiplication-addition : le vecteur du token par la ligne de poids. Deux opérations pour quatre octets lus.
Une carte a deux limites : ce qu'elle calcule par seconde, et ce qu'elle lit par seconde.
D'après la fiche de NVIDIA (GA102 GPU Architecture,
annexe A), la RTX 3090 fait 35,6 téraopérations par seconde en f32 et lit 936 Go par
seconde. Elle fait donc 38 opérations dans le temps qu'il lui faut pour lire un octet.
Un calcul qui fait moins de 38 opérations par octet lu attend la mémoire, quoi qu'on fasse des calculs. C'est le modèle « roofline » (Williams, Waterman et Patterson, 2009) : la performance possible est le minimum de deux droites, celle de la mémoire, qui monte avec le nombre d'opérations par octet, et celle du calcul, plate.
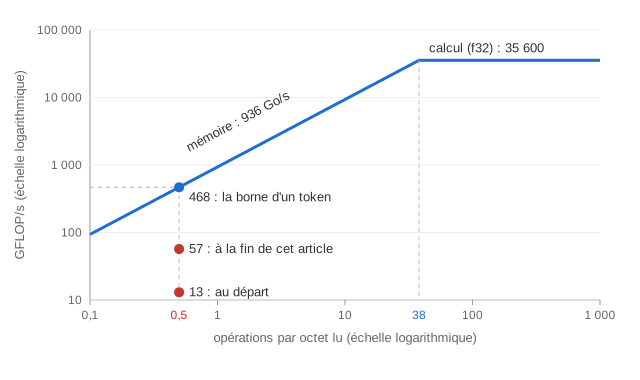
Générer un token, c'est 0,5 opération par octet : tout au fond de la pente. La borne est
celle de la mémoire. Les 29,4 millions de poids en f32 font 118 Mo. Lus à 936 Go/s,
il faut 0,13 ms. Plus le cache des positions passées, que l'attention relit à chaque
token : 32 Ko par position, soit 8 Mo en moyenne sur 500 tokens. Au total, environ
7 400 tokens par seconde.
Nous en faisons 225, trente fois moins.
Le profil
On peut faire une première hypothèse : un token lance quelques centaines de kernels, chacun coûte quelques microsecondes de lancement, et c'est ce coût fixe qui dominerait.
Pour le vérifier, il faut voir chaque kernel. Le profileur de la série chronomètre les opérations en attendant la carte après chacune, ce qui fausse justement ce qu'on veut mesurer ici. NVIDIA fournit mieux : Nsight Systems enregistre chaque lancement et chaque kernel, avec leurs horaires, sans rien changer à l'exécution.
$ nsys profile generate … --tokens 300
| Kernel | Appels par token | Durée moyenne | Part du temps de la carte |
|---|---|---|---|
matmul_tiled | 57 | 57 µs | 81 % |
attention_forward | 8 | 34 µs | 7 % |
binary | 97 | 1,8 µs | 4 % |
permute | 65 | 2,6 µs | 4 % |
| les autres | 76 | 4 % |
303 kernels par token. La carte calcule 4,0 ms par token sur 4,4 : elle est occupée presque tout le temps. L'hypothèse était fausse. Ce ne sont pas les lancements, c'est le produit matriciel, le plus souvent, pour multiplier un vecteur par une matrice.
Pourquoi le produit matriciel rame
Le kernel de l'article 11 découpe la sortie en tuiles de 64 × 64. Un bloc de 256
threads calcule une tuile en avançant le long de la dimension commune par tranches de
16, chargées en mémoire partagée.
Dans a · b, b est la matrice de poids et a porte une ligne par token qui la
traverse. À l'entraînement, tout le texte est connu d'avance : les 16 séquences de 512
tokens du lot passent ensemble. En génération, chaque token dépend du précédent, et on
n'en produit qu'un à la fois.
À l'entraînement, a a 8 192 lignes, une par position du lot : 128 tuiles de lignes,
autant de blocs, et toute la carte travaille. En génération, a a une seule ligne.
Chaque tuile n'en a qu'une d'utile sur 64, et surtout, la grille ne compte plus qu'un
bloc par tuile de colonnes : 8 blocs pour une sortie de 512 colonnes. La carte a 82
multiprocesseurs. Huit travaillent.
Et chacun travaille mal. Un thread lit un élément, attend qu'il arrive, puis lit le
suivant. Pour occuper la mémoire, il faut des milliers de lectures en cours en même
temps : la latence d'une lecture est de l'ordre d'une microseconde, et pendant ce temps
la carte pourrait en servir près d'un mégaoctet. Avec 8 blocs, on est loin du compte.
Dans le même profil, un vecteur face à une matrice 512 × 512 (1 Mo de poids) prend
46 µs : 23 Go/s, quarante fois moins que la bande passante (les 57 µs du tableau sont une
moyenne sur toutes les formes, dont les couches quatre fois plus larges qui suivent
l'attention dans chaque bloc).
Les Tensor Cores n'y changent rien, au contraire : en précision mixte, la génération
tombe à 173 tokens par seconde. Il n'y a rien à calculer plus vite, et le kernel bf16
convertit en plus chaque poids avant de s'en servir.
Un kernel pour les matrices étroites
Il faut un autre découpage, quand a n'a que quelques lignes. Le travail ne se répartit
plus selon la sortie, qui est trop petite, mais selon les poids, qui sont gros.
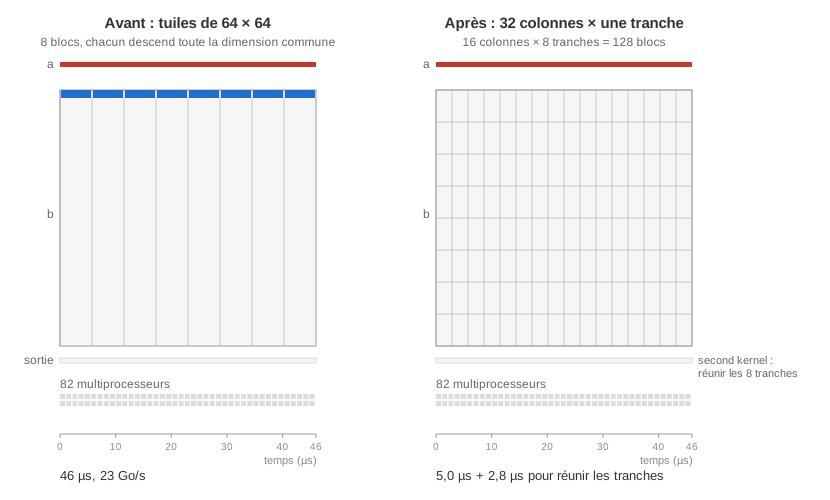
un bloc = 8 warps × 32 threads
        = 32 colonnes de b  ×  une tranche de la dimension commune
Les 32 threads d'un warp lisent 32 colonnes voisines d'une même ligne de poids : 128 octets contigus, une seule transaction mémoire. Les 8 warps du bloc se partagent la tranche, un indice sur huit chacun. Et chaque thread lit quatre poids d'un coup avant de s'en servir, pour avoir plusieurs lectures en cours :
let mut weights = ;
unroll!;
La macro unroll! est celle de l'article 17 de la première série : le compilateur de
kernels ne déroule pas les boucles, et un tableau indexé dans une boucle irait en mémoire
locale. Les sommes des huit warps sont ensuite réunies en mémoire partagée.
Reste à occuper la carte : 512 colonnes ne font que 16 blocs de 32. La dimension commune
est donc découpée en tranches, pour viser 256 blocs, sans descendre sous 64 indices par
tranche : une matrice 512 × 512 en a 8, soit 128 blocs, plus que de multiprocesseurs.
Chaque tranche écrit sa somme partielle, et un second kernel les additionne. Une addition
atomique dans la sortie éviterait ce second kernel, mais l'ordre des additions
dépendrait alors de l'ordre d'arrivée des blocs, et le résultat changerait d'une
exécution à l'autre, de quelques ulps. Nous gardons des résultats reproductibles.
Ce kernel sert dès que a a au plus 16 lignes, y compris en précision mixte : il lit
les poids en f32 et calcule en f32, puisque convertir ne ferait rien gagner. Il est
testé contre le CPU, avec une tolérance rapportée à |a| · |b| : les sommes ne sont plus
faites dans le même ordre, et sur 1 000 termes, un résultat proche de zéro peut s'écarter
de plus de 1e-5 en relatif sans que rien ne soit faux.
586 tokens par seconde (620 en précision mixte)
Deux fois et demie plus vite. Le produit matriciel ne prend plus qu'un quart du temps de la carte, et le profil montre d'autres choses.
Un cache qui ne grandit plus
Le cache de la première série gardait, pour chaque couche, les clés et les valeurs de
toutes les positions passées dans un tenseur [T, H, D]. Un tenseur ne se modifie pas :
à chaque token, concat_rows en créait un nouveau, d'une position de plus, en recopiant
tout l'ancien. Puis une transposition le recopiait encore, en [H, T, D], pour
l'attention. Deux copies du cache entier, par couche et par token.
Et chaque nouveau tenseur avait une taille jamais vue. La réserve de tampons du backend GPU range les tampons par taille exacte : elle ne servait plus à rien, et chaque token coûtait 34 allocations au pilote.
Le cache est réécrit autour d'une idée simple : des tables allouées une fois, une ligne par position, et des positions qu'on écrit sur place.
Les lignes sont distribuées par pages de 16. Une séquence prend une page dans la réserve quand elle en a besoin, et la liste de ses pages dit où sont ses positions. Avec une seule séquence, c'est un détour. Mais c'est la forme qu'il faudra pour générer plusieurs séquences à la fois, à l'article suivant, et pour servir des requêtes de longueurs quelconques, au dernier.
Écrire sur place demande une primitive nouvelle. Jusqu'ici, seuls les pas d'optimiseur modifiaient un tenseur existant. L'écriture dans le cache est la troisième exception :
/// Écrit la ligne `r` de `rows` à la ligne `indices[r]` de `table`, sur place.
;
Les indices voyagent dans un tenseur ordinaire, en f32, qui représente exactement tout
entier jusqu'à 2²⁴. C'est un peu inattendu, mais ils sont alors envoyés une fois par
passe, et toutes les couches s'en servent. Un envoi de l'hôte vers la carte attend que
la carte ait vidé sa file : un par couche coûterait cher.
L'attention change aussi. Elle ne reçoit plus des clés contiguës, mais des tables et, pour chaque requête, la liste des lignes de sa séquence :
/// q [R, H, D], keys et values [lignes, H, D], slots [S, L], rows [R, 2]
Sa définition de référence rassemble les lignes de chaque requête, puis calcule le softmax ordinaire. Son kernel suit l'idée de flash-decoding (Dao, Haziza, Massa et Sizov, 2023). L'attention fusionnée de la première série parallélise sur les requêtes : un bloc pour 32 ou 64 d'entre elles. En génération, il n'y a qu'une requête par tête, et l'ancien kernel n'avait qu'un bloc par tête, 8 en tout, qui parcouraient seuls les 500 clés. Ici, les clés sont découpées en tranches, une par bloc. Chaque bloc tient son softmax en ligne sur sa tranche, et un second kernel réunit les tranches comme le softmax en ligne réunit les tuiles : en corrigeant chaque somme par l'exponentielle de l'écart des maximums.
Dans un bloc, quatre warps de quatre groupes de huit threads lisent seize clés à la fois. Les huit threads d'un groupe se partagent les 64 composantes d'une clé, et réunissent leur produit scalaire par trois échanges entre registres.
828 tokens par seconde
Les allocations ont disparu : 767 en tout pour 300 tokens, chargement du modèle compris, contre 34 par token.
Deux opérations de trop
Le profil montrait alors un kernel permute de 70 µs, une fois par token. C'est la sortie
du modèle. Les logits sont le produit des états par la table d'embedding transposée,
[C, V], et la tape la transposait réellement : 16 Mo recopiés à chaque token, pour une
seule ligne de logits.
Une opération TransposedMatmul calcule a · bᵀ sans recopier b. Chaque élément de la
sortie est le produit scalaire de deux lignes ; un warp lit une ligne de la table, ses 32
threads côte à côte. Elle lit les 16 Mo en 22 µs : 760 Go/s, 81 % de la bande passante
annoncée. C'est ce qu'on peut attendre de mieux d'un kernel.
Puis le biais. Une couche affine était un produit puis une addition, deux kernels, et
l'addition relisait toute la sortie pour y ajouter le biais. L'opération Affine fait
les deux : le kernel des matrices étroites ajoute le biais au passage, ou celui qui réunit
les tranches.
Sa rétropropagation est écrite primitive par primitive comme la tape la faisait pour le
produit puis l'addition : un test vérifie que les gradients sont les mêmes au bit près,
et l'entraînement ne change pas. Il y gagne même quelque chose qu'on n'avait pas cherché.
La tape ne garde plus le résultat intermédiaire du produit, et un pas d'entraînement
du modèle xl passe de 7,0 à 5,5 Gio, à vitesse égale.
Le bilan
| Étape | f32 | Précision mixte |
|---|---|---|
| Départ | 225 | 173 |
| Produit des matrices étroites | 586 | 620 |
| Cache en tables, attention par tranches de clés | 828 | 840 |
| Sortie sans transposition | 884 | 894 |
| Biais ajouté par le produit | 969 | 984 |
Tokens par seconde, sur 500 tokens en mode glouton.
Quatre fois plus vite, et sans changer ce que dit le modèle. Le chemin de la génération passe maintenant par d'autres kernels que celui de l'entraînement : pour le vérifier, la même génération est refaite sans cache, en recalculant toute la séquence à chaque token avec les kernels de l'entraînement. Sur 400 tokens, le texte est identique, en mode glouton comme en tirage à graine fixe.
Le nouveau profil :
| Kernel | Appels par token | Durée moyenne | Part |
|---|---|---|---|
matmul_narrow | 56 | 5,0 µs | 34 % |
sum_splits | 56 | 2,8 µs | 19 % |
attention_cached | 8 | 15 µs | 14 % |
binary | 41 | 1,8 µs | 9 % |
| les autres | 84 | 24 % |
245 kernels par token. La carte calcule 0,83 ms par token, et en reste inoccupée un quart du temps : elle attend l'hôte, qui passe 1,8 µs à lancer chaque kernel.
Ce qui reste : les lancements
Nous sommes à 969 tokens par seconde, pour une borne de 7 400 : 13 %. L'écart n'est plus dans un kernel. Il est dans leur nombre.
Un produit d'un vecteur par une matrice 512 × 512 lit 1 Mo, soit 1,1 µs à pleine bande
passante. Le nôtre prend 5,0 µs, plus 2,8 µs pour réunir ses tranches. Une partie de cet
écart est le coût fixe de tout kernel : démarrer les blocs, attendre les premières
lectures, finir les derniers. Sur des kernels aussi courts, ce coût fixe est l'essentiel.
La réponse habituelle est double. Fusionner : moins de kernels, chacun plus long.
L'opération Affine en est un exemple ; la normalisation, les additions résiduelles et la
rotation de RoPE pourraient suivre. Et les graphes CUDA : enregistrer une fois la
suite des lancements d'un token, puis la rejouer d'un seul appel, sans repasser par
l'hôte.
cuda-oxide sait le faire : son crate cuda-async enregistre et rejoue des graphes, et le
stream de cuda-core expose la capture. Mais notre backend n'est pas prêt pour eux. Un
graphe rejoue les mêmes kernels, sur les mêmes tampons, avec les mêmes tailles. Or, à
chaque token, nos tampons sortent de la réserve dans un ordre quelconque, la table des
lignes s'allonge d'une case, et les envois vers la carte attendent qu'elle ait vidé sa
file, ce qu'une capture interdit. Il faudrait une passe de génération écrite à part, aux
tampons fixés d'avance. Le gain est borné par le temps de calcul de la carte, 0,83 ms par
token : au mieux 1 200 tokens par seconde, un quart de plus.
L'article suivant prend un autre chemin. Une passe lit 118 Mo pour un seul token. Si elle servait à soixante-quatre séquences à la fois, chaque poids lu servirait soixante-quatre fois.
Ce qu'il faut retenir
- Générer un token, c'est lire tout le modèle pour 0,5 opération par octet : la borne est la bande passante, ici environ 7 400 tokens par seconde.
- Un profil avant toute hypothèse. Celle du coût des lancements était fausse au départ, et ne devient vraie qu'à la fin.
- Un kernel taillé pour l'entraînement peut être quarante fois trop lent en génération : la grille doit se découper selon ce qui est gros, ici les poids.
- Un cache qui grandit par copies coûte des copies et des allocations. Des tables fixes, écrites sur place, ne coûtent ni l'un ni l'autre.
- Une fois les gros kernels réglés, le temps est dans leur nombre : 245 par token.
Article suivant : Générer à plusieurs.