Articles · Smallem : un LLM en Rust et CUDA, à partir de zéro
L'attention et le Transformer
Huitième article de la série Smallem. Précédent : Un premier réseau qui apprend.
Dans cet article on construit un GPT, pièce par pièce. Et la bonne nouvelle est qu'il n'y a presque rien de nouveau à écrire côté machine : toutes les opérations nécessaires existent depuis l'article 5, et la rétropropagation depuis l'article 6. Il ne reste qu'à les assembler.
Le problème à résoudre
Le modèle de l'article précédent avait deux défauts de construction.
- Il voyait exactement 16 tokens, ni plus ni moins.
- Chaque position avait ses propres poids. Ce qu'il apprenait sur le token en troisième position ne lui servait à rien pour le même token en septième position.
Or, dans une phrase, ce qui compte n'est pas la place d'un mot mais sa relation aux autres. Pour deviner la fin de « Le chat que les enfants ont nourri ce matin dort », il faut relier « dort » à « chat », six mots plus tôt.
L'attention est le mécanisme qui permet à chaque position d'aller chercher, parmi toutes les positions précédentes, celles qui lui sont utiles. Le Transformer, qui la met au centre, vient de Attention Is All You Need (Vaswani et al., 2017).
L'attention, par une image
Imaginons que chaque position de la séquence tienne trois fiches.
- Une requête : ce que je cherche.
- Une clé : ce que je propose aux autres.
- Une valeur : ce que je transmets à qui s'intéresse à moi.
Chaque position compare sa requête aux clés de toutes les autres. Plus une requête et une clé se ressemblent, plus le score est élevé. La position reçoit alors un mélange des valeurs de toutes les autres, pondéré par ces scores.
Les trois fiches ne sont pas écrites à la main : ce sont trois couches linéaires, appliquées au vecteur de chaque position, et dont les poids sont appris. Le réseau découvre seul ce qu'il est utile de chercher et de proposer.
En formules, pour une séquence de T positions :
scores  = requêtes · clésᵀ / √D        [T, T]   un score par paire de positions
poids   = softmax(scores)              [T, T]   chaque ligne somme à 1
sortie  = poids · valeurs              [T, D]   un mélange de valeurs par position
La « ressemblance » entre une requête et une clé est leur produit scalaire. Le produit
matriciel requêtes · clésᵀ calcule d'un seul coup les T × T produits scalaires. Le
softmax transforme ensuite chaque ligne de scores en poids positifs de somme 1.
La division par √D garde les scores dans une plage raisonnable. Un produit scalaire de
deux vecteurs de D nombres grandit avec D. Sans cette division, les scores seraient
grands, le softmax donnerait presque tout le poids à une seule position, et les gradients
s'éteindraient.
Interdire le futur
Le modèle apprend à prédire le token suivant. À la position 5, il doit deviner le token 6. Si l'attention lui laissait regarder la position 6, il n'aurait qu'à recopier la réponse.
Il faut donc que chaque position ne voie qu'elle-même et celles qui la précèdent. C'est le
masque causal. Dans la matrice des scores, la ligne t est celle de la position t.
On neutralise toutes les colonnes situées après t :
        col 0  col 1  col 2  col 3
ligne 0   ✓      ✗      ✗      ✗
ligne 1   ✓      ✓      ✗      ✗
ligne 2   ✓      ✓      ✓      ✗
ligne 3   ✓      ✓      ✓      ✓
Neutraliser, c'est mettre le score à moins l'infini avant le softmax : son exponentielle vaut zéro, donc son poids aussi.
Ce masque a une conséquence très avantageuse : Une séquence de T tokens fournit T
exemples d'entraînement d'un coup : la position 0 prédit le token 1, la position 1 prédit
le token 2, et ainsi de suite, toutes en une seule passe. Le modèle de l'article précédent
ne tirait qu'un exemple de chaque fenêtre.
Plusieurs têtes
Une seule attention ne peut suivre qu'un type de relation à la fois. On en fait donc tourner plusieurs en parallèle, les têtes, chacune avec ses propres requêtes, clés et valeurs. L'une peut suivre le sujet du verbe, une autre la ponctuation.
L'astuce est de ne pas multiplier le travail. On découpe le vecteur de dimension C en H
morceaux de dimension D = C / H, et chaque tête travaille sur son morceau. Avec C = 512
et 8 têtes, chacune dispose de 64 nombres.
Tout se joue dans un changement de forme :
[B, T, C] ──reshape──► [B, T, H, D] ──transpose──► [B, H, T, D]
Le reshape découpe C en H paquets de D. La transposition amène l'axe des têtes
devant celui des positions. On obtient, pour chaque séquence et chaque tête, une matrice
[T, D]. Grâce à la convention des lots de la matmul, toutes les têtes de toutes les
séquences sont alors traitées en un seul produit.
Voici le code complet :
Chaque ligne correspond à une étape décrite plus haut. Les deux dernières font le chemin inverse du découpage, puis une couche linéaire recombine les sorties des têtes.
Deux paramètres ne servent pas à l'entraînement d'un GPT-2, et valent None dans tout cet
article. cache sert à la génération : on y revient à l'article 11, et on verra que c'est
bien la même fonction qui sert dans les deux cas. rope est une autre façon de faire
connaître les positions au modèle, qui sort du cadre de cette série.
Suivre les formes est la meilleure façon de lire ce genre de code. Presque tous les bugs
d'un Transformer sont des erreurs de forme, ou pire, des formes justes obtenues par un
reshape là où il fallait un transpose.
La normalisation
Empiler des dizaines de couches pose un problème de stabilité. À chaque couche, les valeurs peuvent grossir un peu, ou rapetisser un peu. Au bout de vingt couches, « un peu » devient énorme ou nul.
La LayerNorm y remédie. Pour chaque vecteur, elle retire sa moyenne et le divise par son écart-type. Le résultat a une moyenne de 0 et une variance de 1, quelle que soit l'échelle de l'entrée. Deux paramètres appris, un gain et un biais, lui permettent ensuite de retrouver l'échelle qui convient.
Le EPSILON, qui vaut 1e-5, est ajouté à la variance pour ne jamais diviser par zéro.
Le petit réseau de chaque bloc
L'attention fait circuler l'information entre les positions. Il faut aussi la transformer. Chaque bloc contient donc un petit réseau à deux couches, appliqué à chaque position séparément :
C ──► 4C ──► GELU ──► C
Il passe par une couche quatre fois plus large, applique une fonction non linéaire, puis
revient à la dimension de départ. La fonction s'appelle GELU. Elle ressemble à
max(0, x) en plus lisse : presque nulle pour les valeurs négatives, presque x pour les
grandes valeurs positives.
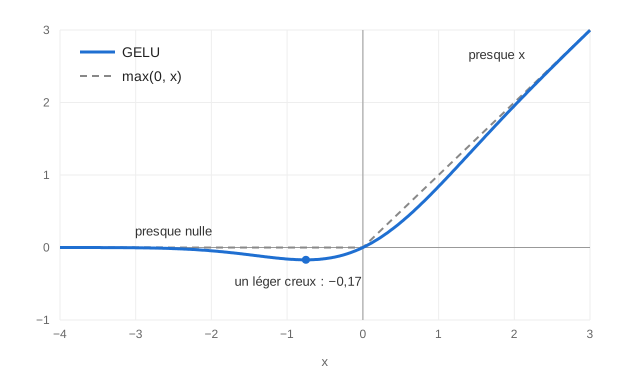
On utilise l'approximation de GPT-2, pour rester compatible avec ses poids :
Cette fonction illustre un avantage de l'approche choisie. Elle est écrite une fois, en Rust ordinaire, générique sur le type flottant. Elle est compilée pour le processeur et pour le GPU : les deux backends appliquent exactement la même formule, sans risque qu'une copie diverge de l'autre.
Le bloc et les connexions résiduelles
Un bloc de Transformer assemble ces pièces :
Le bloc ne fait que transmettre rope et cache à son attention. Grâce à la macro de
l'article précédent, il devient un module en une ligne, et ses paramètres prennent le nom
de ses champs :
module!;
Les deux tape.add(x, …) sont les connexions résiduelles, et ce sont peut-être les
lignes les plus importantes de l'architecture. Chaque sous-couche ne remplace pas x : elle
calcule une correction, qu'on lui ajoute.
On peut voir x comme un flux qui traverse tout le modèle. Chaque bloc y lit, calcule
quelque chose, et y écrit un complément. Deux bénéfices en découlent.
- Une sous-couche qui n'a rien d'utile à dire peut ajouter zéro. Elle ne dégrade rien.
- Le gradient dispose d'un chemin direct de la sortie jusqu'à l'entrée. On a vu qu'une addition transmet le gradient tel quel : il traverse donc tous les blocs sans être atténué. Sans cela, un modèle profond n'apprendrait pas.
La normalisation est appliquée à l'entrée de chaque sous-couche, pas à sa sortie. C'est la variante dite « pré-norme », celle de GPT-2 : le flux résiduel lui-même n'est jamais normalisé.
Le modèle complet
tokens [B, T]
   │
   ├─► embedding des tokens     [B, T, C]
   ├─► embedding des positions     [T, C]      (ajouté par broadcasting)
   ▼
 N blocs                        [B, T, C]
   ▼
 LayerNorm finale               [B, T, C]
   ▼
 logits                         [B, T, V]
Deux points méritent une explication.
Les positions. L'attention compare des requêtes et des clés sans savoir où elles se trouvent. Si l'on mélangeait les mots d'une phrase, elle donnerait le même résultat, mélangé de la même façon. Pour que l'ordre existe, on ajoute à chaque token un second vecteur appris, qui dépend de sa position. Il y en a un par position possible, ce qui fixe la longueur maximale d'une séquence : le contexte.
Le partage des poids. À l'entrée, une table [V, C] transforme chaque token en
vecteur. À la sortie, il faut l'inverse : transformer un vecteur en un score par token. On
réutilise la même table, transposée :
let unembedding = tape.transpose;
tape.matmul
Le score d'un token est le produit scalaire entre le vecteur de sortie et l'embedding de ce token. Cela économise des millions de paramètres, et c'est ce que fait GPT-2.
C'est aussi le cas annoncé à l'article 6 : un même paramètre sert à deux endroits du calcul. Comme il ne s'inscrit qu'une fois sur la tape, il reçoit bien la somme des deux gradients.
Un détail d'initialisation
Chaque bloc ajoute deux contributions au flux résiduel. Avec N blocs, 2N contributions
s'additionnent, et la variance du flux grandirait avec la profondeur.
Les couches qui écrivent dans le flux sont donc initialisées avec un écart-type plus petit,
divisé par √(2N). Au départ, le modèle se comporte ainsi presque comme s'il n'avait pas de
blocs, et chacun apprend progressivement sa contribution.
Les tests
Le Transformer reprend les trois contrôles de l'article précédent, et en ajoute deux.
Le test du futur
C'est le test le plus important du modèle. Une fuite du futur est un bug particulièrement vicieux : elle ne casse rien. Au contraire, la perte devient excellente, puisque le modèle triche. On ne s'en aperçoit qu'à la génération, quand il n'y a plus de futur à regarder et que le texte est du bruit.
Le test est simple : modifier le token à la position t ne doit changer aucun logit aux
positions avant t.
let tokens = ;
let before = run;
let mut changed = tokens;
changed = 99;
let after = run;
let split = 5 * VOCAB;
assert_eq!;
assert_ne!;
La seconde assertion compte autant que la première. Elle vérifie que le changement a bien un effet là où il doit en avoir. Sans elle, un modèle qui ignorerait complètement son entrée passerait le test.
Le gradient de tout le modèle
Un modèle minuscule, à une couche et de dimension 8, est vérifié par différences finies : ses mille paramètres, un par un. C'est la vérification de l'article 6, appliquée cette fois à l'assemblage entier.
Ce test a révélé une propriété amusante. Le biais des clés a un gradient exactement nul. Il ajoute la même quantité à tous les scores d'une même requête, et le softmax est insensible à un décalage commun. Ce paramètre ne sert donc à rien. GPT-2 le garde, on le garde aussi pour pouvoir charger ses poids, et le test affirme simplement que ce gradient est nul.
Deux configurations
| Petite | Grande | |
|---|---|---|
| Couches | 4 | 6 |
| Têtes | 4 | 6 |
Dimension C | 128 | 384 |
Contexte T | 64 | 256 |
| Paramètres | 834 432 | 10 844 544 |
La petite sert aux tests et tourne même sur le backend CPU. La grande est faite pour le GPU.
Une mauvaise surprise
Tous les tests passent. Le modèle est juste. Reste à mesurer sa vitesse :
| Configuration | Lot | Tokens par seconde | Temps par pas |
|---|---|---|---|
| Petite | 32 × 64 | environ 36 000 | 57 ms |
| Grande | 16 × 256 | environ 6 750 | 606 ms |
C'est lent. À ce rythme, un entraînement convenable de la grande configuration prendrait plus de trois heures.
Les kernels de l'article 5 étaient écrits pour être justes, pas pour être rapides, et le Transformer le fait payer. La multiplication de matrices naïve pèse un peu plus de la moitié du temps. Le reste vient de dizaines de petites opérations : une LayerNorm écrite avec les primitives, par exemple, c'est une dizaine de lancements et autant de passes sur la mémoire.
Il a donc fallu faire un détour par la performance avant d'entraîner. Trois changements, détaillés à l'article 11, ont ramené la grande configuration de 606 à 123 ms par pas. Les résultats de l'article suivant ont été obtenus après ce détour.
Le code montré plus haut est d'ailleurs celui d'aujourd'hui. Les appels causal_softmax et
normalize sont deux des opérations fusionnées issues de ce détour : dans la première
version, le masque était un tenseur rempli par masked_fill, et la normalisation une suite
de soustractions, de moyennes et de divisions.
Ce qu'il faut retenir
- L'attention laisse chaque position chercher, parmi les précédentes, celles qui lui sont utiles : requête, clé, valeur.
- Le masque causal interdit de regarder le futur, et fait de chaque séquence
Texemples d'entraînement. - Les têtes sont un découpage du vecteur, obtenu par
reshapepuistranspose. - Les connexions résiduelles font du modèle un flux auquel chaque bloc ajoute une correction.
- Le test du futur est celui qu'il ne faut jamais omettre.
Le modèle existe, et il est vérifié. Il reste à l'entraîner pour de bon : Entraîner, sauvegarder, générer.