Articles · Smallem : un LLM en Rust et CUDA, à partir de zéro
Entraîner, sauvegarder, générer
Neuvième article de la série Smallem. Précédent : L'attention et le Transformer.
Le Transformer existe et passe ses tests. Cet article en fait un programme complet : un entraînement mené jusqu'au bout, un fichier de poids, et un générateur de texte. Il se termine par l'épreuve la plus exigeante de toute la série : charger dans notre code un modèle entraîné par d'autres, et obtenir les mêmes nombres qu'eux.
Faire varier le taux d'apprentissage
Jusqu'ici le taux d'apprentissage était constant. Sur un Transformer, cela marche mal, pour deux raisons opposées.
Au tout début, les poids sont aléatoires et les moyennes d'Adam ne sont pas encore fiables. De grands pas dans ces conditions peuvent envoyer le modèle dans une région dont il ne revient pas. Il faut commencer doucement.
À la fin, c'est l'inverse. Le modèle est près d'un bon réglage, et de grands pas le font osciller autour sans s'y poser. Il faut finir doucement.
On fait donc varier le taux en deux phases :
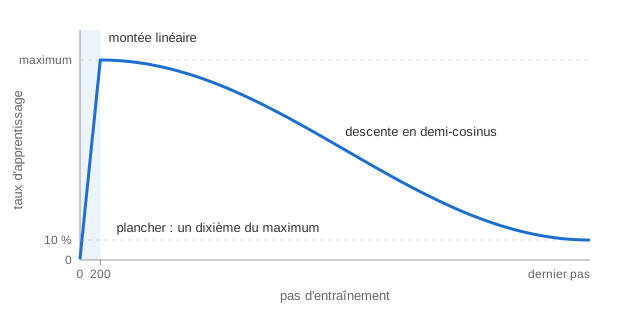
La montée est linéaire, sur 200 pas. La descente suit un demi-cosinus : lente au début, plus rapide au milieu, lente à la fin. Le taux finit à un dixième de son maximum.
Écrêter le gradient
De temps en temps, un lot inhabituel produit un gradient énorme. Le pas qui en découle peut détruire en une fois ce que le modèle a mis des milliers de pas à apprendre.
La parade consiste à mesurer la norme du gradient, c'est-à-dire la longueur du vecteur formé par tous les gradients de tous les paramètres mis bout à bout. Si elle dépasse un seuil, 1 par défaut, on réduit tout le gradient d'un même facteur pour la ramener au seuil.
let norm = gradient_norm;
let grad_scale = if norm > max_norm else ;
optimizer.step;
On garde la direction du gradient, on borne seulement la taille du pas. Le facteur est passé au kernel d'AdamW, qui multiplie chaque gradient avant de s'en servir : aucun lancement supplémentaire.
Cet écrêtage a un coût. Il faut calculer la norme, soit plusieurs lancements par paramètre, puis la lire sur l'hôte à chaque pas. Sur la petite configuration, le débit baisse d'environ 12 %. Sur la grande, rien de mesurable : les kernels du modèle y sont si longs que ce supplément ne compte plus.
Sauvegarder les poids
Un modèle entraîné qu'on ne peut pas enregistrer ne sert à rien. Le format choisi s'appelle safetensors. Il a deux qualités : il est très simple, et c'est celui dans lequel sont publiés les poids de GPT-2. Le même lecteur servira aux deux.
8 octets   la taille N de l'en-tête
N octets   l'en-tête, en JSON
le reste   les données brutes des tenseurs, bout à bout
L'en-tête décrit chaque tenseur : son nom, son type, sa forme, et l'intervalle d'octets qu'il occupe dans la suite du fichier.
Les noms des tenseurs sont ceux que donne le parcours des paramètres de l'article 7 :
blocks.0.attention.query.weight est le champ weight de la couche query de l'attention
du premier bloc. Enregistrer un modèle, c'est le parcourir et écrire chaque paramètre sous
son nom. Le recharger, c'est le parcourir de nouveau et chercher chaque nom dans le
fichier.
Les métadonnées portent la configuration du modèle. Le format n'y admet que des paires de textes : la configuration y est donc rangée comme un seul texte, lui-même en JSON. Une description imbriquée y tient sans effort, là où une liste de champs à plat obligerait à inventer une convention de nommage dès que l'architecture a des variantes. Le programme de génération reconstruit ainsi le bon modèle à partir du seul fichier, sans qu'on lui redonne l'architecture.
La boucle d'entraînement
Il reste à assembler ces pièces. La boucle fait un pas après l'autre et, à intervalles réguliers, évalue le modèle sur la validation et l'enregistre si sa perte s'est améliorée.
Cette boucle n'est pas dans le programme train. Elle est dans la bibliothèque, sous la
forme d'un Trainer qui réunit ce qu'un entraînement ne change pas en cours de route :
let trainer = Trainer ;
let summary = trainer.run?;
Deux choix sont à remarquer.
La boucle n'affiche rien. Elle rapporte ce qui se passe par des événements, et c'est
l'appelant qui décide de leur présentation. Le programme train les imprime ; un test les
range dans un tableau et les examine.
Ses données sont un trait. Elle demande seulement de quoi tirer des lots :
Un corpus de plusieurs gigaoctets sur disque le remplit, et un tableau de 600 tokens en mémoire aussi.
Ces deux choix ont le même but : la boucle se teste comme n'importe quelle fonction. Sur CPU, avec un modèle minuscule et un corpus de 600 tokens, les tests vérifient que les évaluations arrivent au rythme demandé et au dernier pas, que le modèle enregistré est bien le meilleur, et qu'une perte devenue infinie arrête tout sans rien écrire. Sans cela, la seule façon de vérifier la boucle serait de lancer un entraînement et de regarder l'écran.
Le programme train, lui, ne fait plus que trois choses : lire ses options, ouvrir le
corpus, afficher les événements.
Générer du texte
La génération est une boucle. On donne au modèle un début de texte, l'amorce. Il rend 257 scores pour le token suivant. On en tire un, on l'ajoute au texte, et on recommence.
Le modèle calcule en réalité les logits de toutes les positions, mais seule la dernière prédit un token qu'on ne connaît pas encore.
Le modèle lui-même ne sait pas générer : il ne sait que donner des scores. La boucle est
tenue par un objet à part, le Generator, qui garde la séquence d'un tour à l'autre :
let mut generator = new;
for _ in 0..length
next_token fait les trois gestes : demander les scores, tirer un token, l'ajouter. Comme
l'appelant reçoit chaque token dès qu'il est tiré, le programme generate affiche le texte
à mesure qu'il s'écrit. On peut aussi imposer un token avec push, ou reprendre plus tard
une génération laissée en plan.
Afficher au fil de l'eau cache un piège. Un caractère accentué occupe plusieurs octets, et rien n'empêche le modèle de les produire dans des tokens différents. Le décodeur garde donc les octets d'un caractère incomplet, et ne rend du texte que lorsque le caractère est entier. Un test vérifie que les morceaux, mis bout à bout, sont exactement le texte décodé en une fois.
Reste à savoir comment tirer. Trois réglages changent beaucoup le texte obtenu.
La température
On divise les logits par un nombre, la température, avant le softmax.
- Température 1 : on tire fidèlement selon les probabilités du modèle.
- Température inférieure à 1 : les écarts entre logits s'accentuent. Les tokens probables le deviennent encore plus. Le texte est plus sûr et plus répétitif.
- Température supérieure à 1 : les écarts s'atténuent. Le texte est plus varié et plus décousu.
- Température 0 : on prend toujours le token le plus probable. Le texte ne dépend plus du hasard.
Top-k
Même peu probables un par un, les mauvais tokens sont nombreux. Ensemble, ils finissent par
être tirés souvent, et un seul suffit à faire dérailler une phrase. Le top-k ne garde que
les k tokens les plus probables et écarte tous les autres.
Top-p
Le top-k a un défaut : k est fixe. Quand le modèle est presque certain du token suivant,
garder 40 candidats est trop. Quand il hésite vraiment entre cent mots plausibles, c'est
trop peu.
Le top-p s'adapte. Il garde le plus petit ensemble de tokens dont la probabilité cumulée
atteint p. Avec p = 0,9, on garde peu de tokens quand le modèle est sûr de lui, et
beaucoup quand il hésite.
// Les indices, du token le plus probable au moins probable.
let mut order: = .collect;
order.sort_by;
let mut kept = order.len;
if let Some = sampling.top_k
if let Some = sampling.top_p
Après filtrage, les probabilités restantes sont renormalisées pour que leur somme vaille 1.
Tout cela se fait sur l'hôte. Quelques centaines de nombres par token généré ne justifient pas un kernel.
Résultats
| Modèle | Lot | Pas | Tokens vus | Durée | Perte de validation |
|---|---|---|---|---|---|
| Bigramme | 2,53 | ||||
| MLP | 1,90 | ||||
| GPT petit, 0,8 million de paramètres | 64 × 64 | 20 000 | 82 millions | 5 min | 1,36 |
| GPT grand, 11 millions de paramètres | 32 × 256 | 6 000 | 49 millions | 25 min | 1,20 |
Le grand modèle n'hésite plus qu'entre 3,3 octets en moyenne, contre 12,6 pour le bigramme et 257 pour le hasard.
Deux observations aident à interpréter ces nombres. La perte baissait encore au dernier pas dans les deux cas. Et les pertes d'entraînement et de validation restent confondues. Autrement dit, ces modèles ne manquent pas de données : ils manquent de temps de calcul. C'est une situation très différente des petits corpus jouets, où le modèle finit par apprendre le texte par coeur, et elle explique la place qu'occupe la performance dans la suite.
Voici un extrait du grand modèle, à température 0,8 et top-k 40 :
The history of science shows that it is low in a child when the social erosion
can show the right to skirts and electricity.
Conserve a problem using a specific picture of recreation; the computer is
therefore.
Presque tous les mots sont corrects, et les phrases ont une grammaire plausible, mais elles n'ont aucun sens. C'est exactement ce qu'on peut attendre d'un modèle qui lit des octets par fenêtres de 256 : il a appris l'orthographe et un peu de syntaxe, pas le sens.
L'épreuve : charger GPT-2
Tous les tests écrits jusqu'ici comparent le code à lui-même : le GPU au CPU, les gradients aux différences finies. Ils prouvent la cohérence interne. Ils ne prouvent pas que l'architecture est bien celle de GPT.
OpenAI a publié les poids de GPT-2 (Radford et al., 2019). Si notre code implémente vraiment la même architecture, alors, chargé avec ces poids, il doit produire les mêmes sorties que l'implémentation de référence.
L'intérêt de l'épreuve est qu'elle ne pardonne rien. GPT-2 small compte 124 millions de paramètres, 12 couches et 12 têtes. Une seule opération légèrement fausse, une normalisation au mauvais endroit, un GELU dans une autre variante, et les logits n'ont plus rien à voir.
La conversion
Les noms des tenseurs diffèrent : il faut les faire correspondre un par un. Une seule vraie
différence de structure apparaît : GPT-2 range les trois projections de l'attention, requête,
clé et valeur, côte à côte dans une seule matrice [C, 3C]. Notre modèle garde trois
matrices [C, C]. Il faut donc découper :
// `c_attn` contient requête, clé et valeur côte à côte.
let weights = split_last_axis;
let biases = split_last_axis;
for in .iter.zip.zip
Le piège le plus connu de cet exercice ne s'est pas présenté : Pour des raisons historiques,
GPT-2 range ses matrices en [entrée, sortie], à l'inverse de la convention habituelle de
PyTorch, et presque tous ceux qui chargent ses poids doivent les transposer. Notre couche
linéaire utilise déjà [entrée, sortie] depuis l'article 7 : il n'y a rien à transposer.
La comparaison
Un petit script Python calcule, avec PyTorch, les logits de référence sur une phrase, et la suite la plus probable de 20 tokens. Le programme Rust charge ces références et compare.
Résultat :
- Logits : un écart maximal de
3,5e-4, sur 402 056 logits dont les valeurs vont jusqu'à 139. - Génération : les 20 tokens produits sont identiques à ceux de PyTorch.
Et cela sur GPU comme sur CPU.
L'écart de 3,5e-4 n'est pas une erreur. Les calculs sont en simple précision, traversent
12 couches, et le GPU n'additionne pas dans le même ordre que PyTorch. Rapporté à des
valeurs qui atteignent 139, c'est un accord sur plus de cinq chiffres.
Ce résultat valide d'un coup tout ce qui précède : la matmul, le softmax, la normalisation, le GELU, l'attention, l'ordre des opérations dans le bloc, le partage des poids. Chacune de ces pièces pouvait être subtilement fausse et passer ses propres tests. Ensemble, elles reproduisent un modèle qu'on n'a pas écrit.
Ce qu'il faut retenir
- Le taux d'apprentissage monte doucement, puis descend en cosinus.
- L'écrêtage borne la taille du pas sans changer sa direction.
- Un fichier safetensors, c'est un en-tête JSON et des données brutes.
- Température, top-k et top-p règlent le compromis entre texte sûr et texte varié.
- Charger GPT-2 et retrouver ses sorties est la validation la plus forte possible.
Le modèle est juste. Sa limite est maintenant ailleurs : il lit des octets, et dépense son contexte à épeler des mots lettre par lettre. L'article suivant change d'unité : Des sous-mots et un entraînement à l'échelle.