Articles · Smallem : un LLM en Rust et CUDA, à partir de zéro
Un premier réseau qui apprend
Septième article de la série Smallem. Précédent : La rétropropagation.
Tout est prêt : des tenseurs sur GPU, et de quoi calculer des gradients. Cet article assemble les deux pour entraîner un premier réseau de neurones. Ce n'est pas encore un Transformer, mais un modèle plus ancien et plus simple. Il suffit à mettre en place tout ce qui fait un entraînement : les paramètres, les couches, l'optimiseur et la boucle.
Le modèle : regarder les 16 derniers octets
Le bigramme de l'article 3 ne voyait qu'un token. Le modèle de cet article en voit seize. Il date de 2003 (Bengio et al., A Neural Probabilistic Language Model) et tient en quatre étapes :
16 tokens ──► 16 vecteurs ──► un seul grand vecteur ──► couche cachée ──► 257 scores
             (embedding)      (mis bout à bout)         (avec tanh)       (logits)
- Chaque token est remplacé par un vecteur de 32 nombres, appris.
- Les 16 vecteurs sont mis bout à bout : 512 nombres.
- Une couche les transforme en 512 autres nombres, et leur applique
tanh. - Une dernière couche en tire 257 scores, un par token possible.
Pour le construire, il faut trois briques.
Les paramètres
Un paramètre est un tenseur que l'entraînement modifie. La tape de l'article précédent sert à un seul calcul : on en crée une neuve à chaque pas, puis on la jette. Les paramètres, eux, doivent survivre d'un pas à l'autre.
Ils vivent donc hors de la tape, dans le modèle :
value est le tenseur lui-même. decay dit si une certaine régularisation s'applique à ce
paramètre (on y revient plus bas). Le champ intéressant est binding.
À chaque pas, le paramètre doit s'inscrire sur la tape du moment, comme feuille, pour
recevoir un gradient. binding retient cette inscription : le numéro de la tape, et la
Var obtenue.
Au premier appel sur une tape donnée, le paramètre crée sa feuille. Aux suivants, il rend la même. Ce détail compte : un paramètre utilisé à deux endroits d'un même calcul doit être un seul nœud, pour que ses gradients s'additionnent. Deux feuilles distinctes recevraient chacune une partie du gradient, et aucune n'aurait le total.
Après la rétropropagation, l'optimiseur retrouve le gradient par le même chemin :
L'embedding
Un token est un numéro. Un numéro n'a aucun sens pour un réseau : le token 65 n'est pas « un peu plus » que le token 64.
On associe donc à chaque token un vecteur, que le réseau apprendra. L'ensemble est une table à 257 lignes, une par token :
L'opération est une simple lecture : pour le token 65, prendre la ligne 65. C'est le
gather_rows de l'article précédent, et sa rétropropagation est le scatter-add atomique.
Au fil de l'entraînement, les tokens qui jouent des rôles voisins finissent avec des
vecteurs voisins.
La couche linéaire
C'est la brique de base de tous les réseaux :
Une multiplication de matrices, plus un biais. Prenons un petit exemple : deux vecteurs d'entrée de 3 nombres, transformés en vecteurs de 2 nombres.
x = [1  2  3]        W = [1  0]        b = [10  20]
    [4  5  6]            [0  1]
                         [1  1]

x · W = [1×1 + 2×0 + 3×1   1×0 + 2×1 + 3×1]  =  [ 4   5]
        [4×1 + 5×0 + 6×1   4×0 + 5×1 + 6×1]     [10  11]

x · W + b = [14  25]
            [20  31]
Chaque ligne de x est un exemple, traité indépendamment. Chaque colonne de W fabrique
un nombre de sortie, comme une combinaison pondérée des entrées. Le biais [2] s'étire sur
les deux lignes par broadcasting.
La matrice est rangée en [entrée, sortie]. C'est un choix de convention, mais c'est aussi
celui de GPT-2, ce qui simplifiera le chargement de ses poids à l'article 9.
Grâce à la convention des lots, la même couche accepte une entrée [B, T, C] et produit
[B, T, D], sans une ligne de code supplémentaire.
Pourquoi une fonction non linéaire
Entre les deux couches linéaires du modèle se trouve un tanh.
Deux couches linéaires collées l'une à l'autre ne font pas mieux qu'une seule : multiplier par une matrice puis par une autre revient à multiplier par une seule matrice, leur produit. Empiler des couches n'apporterait rien.
La fonction tanh casse cette propriété. Elle écrase chaque nombre entre -1 et 1, de façon
non proportionnelle. C'est cette non-linéarité qui donne au réseau la capacité de
représenter autre chose que des combinaisons pondérées.
Le modèle, en entier
Le reshape fait la mise bout à bout sans rien copier : [B, 16, 32] devient [B, 512].
Comme chaque position a sa place fixe dans ce vecteur, le réseau sait quel token était où.
Le modèle compte 402 721 paramètres, répartis dans trois couches.
Retrouver tous les paramètres
L'optimiseur doit mettre à jour tous les paramètres, sans connaître la structure du modèle.
Plus tard, il faudra aussi les enregistrer dans un fichier, chacun sous un nom. Il faut
donc un moyen de les parcourir. C'est le rôle du trait Module.
Un module ne sait faire qu'une chose : présenter ses paramètres un par un, chacun précédé de son nom.
Seules les deux premières méthodes sont à écrire : walk pour lire les paramètres,
walk_mut pour les modifier, ce que fait l'optimiseur.
Le parcours est récursif. Un paramètre est lui-même un module, le plus simple qui soit : il se présente sous le nom qu'on lui donne. Une couche parcourt ses champs, en préfixant le nom de chaque champ. Une suite de couches donne à chacune son rang pour nom.
Une couche n'écrit pas ce parcours à la main. Une macro le fabrique à partir de la liste de ses champs :
module!;
module!;
Le nom des champs devient le nom des paramètres. adapter est une correction facultative
de la couche, qui servira bien plus tard (LoRA, dans la série sur le post-entraînement) :
c'est une Option, vide par défaut, et elle n'ajoute alors aucun nom. Pour ce modèle, le
parcours donne :
embedding.weight hidden.weight hidden.bias output.weight output.bias
Ajouter une couche à un modèle, c'est ajouter un nom à cette liste. Il n'y a rien d'autre à tenir à jour.
L'initialisation
Avant le premier pas, les paramètres doivent avoir une valeur.
Avec tous les poids à zéro, tous les neurones d'une couche calculeraient la même chose, recevraient le même gradient et resteraient identiques pour toujours. On tire donc les poids au hasard, selon une loi normale d'écart-type 0,02. Les biais partent de zéro.
Un petit écart-type a un effet vérifiable. Les logits de départ sont tous proches de zéro,
donc les 257 probabilités presque égales, et la perte initiale doit valoir à peu près
ln 257 ≈ 5,55.
L'optimiseur le plus simple : SGD
SGD signifie stochastic gradient descent, descente de gradient stochastique. La règle est celle annoncée à l'article précédent : chaque paramètre recule d'un pas proportionnel à son gradient.
paramètre ← paramètre - taux × gradient
Le taux d'apprentissage fixe la taille du pas. Trop petit, l'entraînement n'avance pas. Trop grand, il dépasse le creux et la perte explose. « Stochastique » rappelle que le gradient est calculé sur un lot tiré au hasard, et non sur tout le corpus : c'est une estimation bruitée, mais bien moins chère.
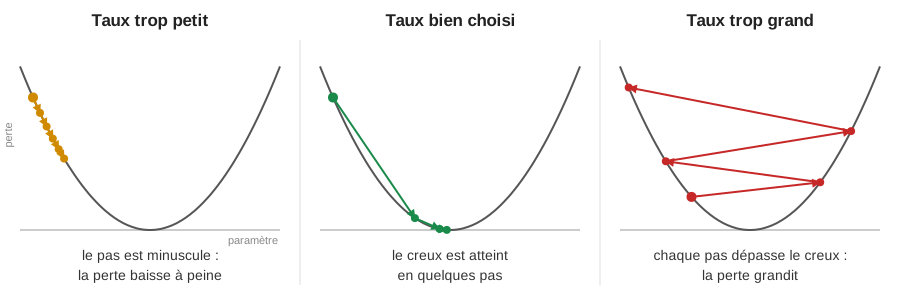
Sur GPU, c'est un kernel d'une ligne :
C'est la seule opération du projet qui modifie un tenseur existant au lieu d'en créer un nouveau. Le paramètre est mis à jour sur place.
Cela impose une règle car la tape qui a servi au calcul référence encore les paramètres. Elle doit avoir disparu avant la mise à jour, sans quoi on modifierait une valeur que quelqu'un d'autre consulte. Sur GPU, l'oublier provoque une panique explicite, plutôt qu'un résultat silencieusement faux.
Un meilleur optimiseur : AdamW
SGD applique le même taux à tous les paramètres. Or certains reçoivent de grands gradients et d'autres de minuscules. Un seul taux convient mal à tous.
Adam adapte le pas de chaque paramètre et AdamW y ajoute une décroissance des poids tenue à part (Loshchilov et Hutter, 2017). Pour chacun, il tient deux moyennes glissantes :
m, la moyenne récente du gradient : la direction générale, lisséev, la moyenne récente du carré du gradient : sa taille habituelle.
Le pas est m / √v. Diviser par la taille habituelle du gradient ramène tous les
paramètres à la même échelle : un paramètre dont le gradient est petit mais régulier avance
aussi vite qu'un autre.
Le « W » ajoute la décroissance des poids : à chaque pas, chaque poids est légèrement
tiré vers zéro. Cela empêche les poids de grossir sans raison. Elle ne s'applique qu'aux
matrices, pas aux biais ni aux embeddings : c'est le rôle du champ decay vu plus haut.
Tout l'optimiseur tient dans un seul kernel, qui met à jour le paramètre et ses deux moyennes en un lancement :
let g = grad * step.grad_scale;
// Moyennes glissantes du gradient et de son carré.
*m = step.beta1 * *m + * g;
*v = step.beta2 * *v + * g * g;
// Les moments partent de zéro : on corrige ce biais.
let m_hat = *m / step.bias_correction1;
let v_hat = *v / step.bias_correction2;
let update = m_hat / ;
*p -= step.learning_rate * ;
La correction de biais mérite un mot. Les deux moyennes partent de zéro, et sous-estiment
donc les vraies valeurs pendant les premiers pas. Diviser par 1 - βᵗ compense exactement,
et ce facteur tend vers 1 à mesure que les pas s'accumulent.
Au tout premier pas, les corrections donnent m̂ = g et v̂ = g², donc un pas de g / |g| : exactement
le taux d'apprentissage, quelle que soit la taille du gradient. Un gradient de 2 et un gradient de 200 donnent le
même déplacement.
Les deux optimiseurs remplissent un même trait, Optimizer. Le code d'entraînement ne sait
pas lequel il utilise.
La boucle d'entraînement
Un pas d'entraînement, quel que soit le modèle : Passe avant, rétropropagation, mise à jour.
Il n'y a pas de « remise à zéro des gradients », l'étape que les utilisateurs de PyTorch connaissent bien. Les gradients appartiennent à la tape et disparaissent avec elle.
La fonction renvoie la perte sous forme de tenseur, sans la lire. Lire un nombre sur le GPU le rapatrie sur l'hôte, ce qui n'est utile que de temps en temps, pour l'affichage.
Et la fonction ne sait rien du modèle : elle reçoit une closure qui construit la perte. Elle servira telle quelle pour le Transformer.
Trois vérifications avant tout entraînement
Un entraînement qui ne marche pas ne dit pas pourquoi. Trois contrôles rapides attrapent la plupart des bugs avant qu'ils ne coûtent des heures.
1. La perte initiale. Elle doit valoir environ ln 257 ≈ 5,55. Sinon, l'initialisation
est mauvaise.
2. Le sur-apprentissage d'un seul lot. En répétant toujours le même lot, le modèle doit l'apprendre par coeur, et la perte tendre vers zéro. S'il n'y arrive pas, il y a un bug dans la passe avant, dans la rétropropagation ou dans l'optimiseur.
3. La même courbe sur CPU et sur GPU. Avec la même graine, les deux backends reçoivent les mêmes poids de départ et les mêmes lots. Leurs pertes doivent coïncider aux arrondis près.
Ces trois tests sont dans la suite du projet, et ils seront repris à l'identique pour le Transformer.
Résultat
Avec des lots de 256 exemples et 20 000 pas d'AdamW, soit 40 secondes sur la carte :
| Mesure | Valeur |
|---|---|
| Perte de validation initiale | 5,5489 (attendu : 5,5491) |
| Perte de validation finale | 1,90 |
| Rappel : bigramme | 2,53 |
| Débit sur GPU | environ 139 000 exemples par seconde |
| Débit sur CPU, même modèle | environ 820 exemples par seconde |
La perte initiale tombe à deux dix-millièmes de la valeur attendue. Au pas 500, le CPU et le GPU affichent la même perte à quatre décimales.
Le modèle passe de 2,53 à 1,90 : il n'hésite plus qu'entre 6,7 octets en moyenne, contre 12,6 pour le bigramme. Dans le texte généré apparaissent de vrais mots courts.
Et le GPU est 170 fois plus rapide que la référence CPU. Celle-ci n'a jamais été faite pour la vitesse, mais l'écart donne la mesure de ce que la carte apporte.
Ce qu'il faut retenir
- Les paramètres vivent hors de la tape et s'y inscrivent à chaque pas, une seule fois.
- Un embedding est une table de vecteurs ; une couche linéaire est une matmul et un biais.
- Sans fonction non linéaire entre elles, plusieurs couches n'en valent qu'une.
- AdamW adapte le pas de chaque paramètre à la taille habituelle de son gradient.
- Trois contrôles avant tout entraînement : perte initiale, sur-apprentissage d'un lot, accord entre CPU et GPU.
Ce modèle a une limite de construction : il voit exactement 16 octets, chacun à une place fixe. Pour aller plus loin, il faut un mécanisme qui laisse chaque position choisir ce qu'elle regarde. C'est l'attention : L'attention et le Transformer.